SQLazy 今天在 Product Hunt 上線囉~~

如果你曾經和 SQL 搏鬥過,這篇文章就是為你準備的。
AI 可以產生可執行的 SQL 語句,但它常常不太可靠。SQLazy 將 SQL 開發轉變成逐步、可驗證且可稽核的工作流程,並透過編譯器確保最終輸出正確。SQLazy 的運作方式?SQLazy 不會一次產生一大塊 SQL。而是將 SQL 開發轉變成逐步且可追蹤的工作流程:
- 使用半自然語言語法來描述每個步驟的作用。
- 在每個步驟驗證邏輯 – 中間結果可以檢查。
- 讓編譯器產生最終的 SQL。
希望能得到你的支持 — 每個讚和留言都很重要:
https://www.producthunt.com/products/sqlazy?utm_source=other&utm_medium=social
非常感謝。
https://dev.to/esproc_spl/sqlazy-is-live-on-product-hunt-today-2id0
https://www.worldprogramming.org/posts/sqlazy-is-live-on-product-hunt-today-suz5dh
每一個 Playwright 測試套件一開始都很乾淨。二十個測試全部綠燈,九十秒內跑完。然後它開始成長。
到了第五十個測試時,有人加入了 waitForTimeout 來「修復」競爭條件。到了第一百個測試時,測試套件大概每四次執行就會失敗一次——而且從來不是同一個測試失敗兩次。人們開始重新執行管線直到它變綠為止。到那個時候,測試套件已經不再是安全網,而是變成了稅負。
我看過這個現象在足夠多的專案上發生,注意到它幾乎總是由相同的五個原因造成。它們沒有一個是特別複雜的。它們如下,每一個都附上對應的修復方式。
1. waitForTimeout 不是等待,它是一場賭博
這是最大的一個。它在測試第一次出現間歇性失敗時就會出現,有人會伸手拿最快速的修復方式:
await page.click('#submit');
await page.waitForTimeout(2000);        // ← the bet
await expect(page.locator('.result')).toBeVisible();
Enter fullscreen mode
Exit fullscreen mode
這場賭博是假設兩秒鐘永遠都足夠。在你的筆電上是足夠的。在凌晨三點負載較重的 CI 執行器上有時就不夠了。而在那些確實足夠的日子裡,你仍然要付出兩秒鐘的代價——乘以一百個測試,你就為每次執行無謂地多增加了三分鐘。
修復方式:等待你真正需要的東西。
await page.click('#submit');
await expect(page.locator('.result')).toBeVisible();   // auto-waits, up to the timeout
Enter fullscreen mode
Exit fullscreen mode
Playwright 的斷言已經會自動重試直到通過或逾時。你幾乎不需要明確的等待。當你真的需要時——例如點擊觸發了一個 XHR,而你需要它的結果才能繼續——就等待那個特定的事情:
const response = page.waitForResponse(res => res.url().includes('/api/order'));
await page.click('#submit');
await response;
Enter fullscreen mode
Exit fullscreen mode
用 lint 來強制執行,而不是靠紀律。 紀律在截止期限壓力下會失效。加入 eslint-plugin-playwright 並將 no-wait-for-timeout 開啟為錯誤。現在管線會拒絕它,沒有人需要在審核時人工檢查。
2. 共用資料的測試在平行執行時會互相碰撞
這個很狡猾,因為它只有在你開啟平行執行後才會出現。
test('registers a new user', async ({ page }) => {
  await registerUser(page, '[email protected]', 'Password123!');
  await expect(page.locator('.welcome')).toBeVisible();
});
Enter fullscreen mode
Exit fullscreen mode
單獨執行時完美無缺。當你用兩個 worker 執行它,或是在沒有重置資料庫的情況下執行兩次,第二個就會碰到「email already registered」。這個失敗看起來像是註冊錯誤。其實不是。這是你的測試資料造成的。
修復方式:為每個測試產生唯一的資料,絕對不要硬編碼。
const user = {
  email: `qa.${randomUUID().split('-')[0]}@example.com`,
  password: 'Str0ng!Passw0rd',
};
Enter fullscreen mode
Exit fullscreen mode
寫一個小型的工廠模組是很值得的。而且——這聽起來過度,直到它幫你省了一天時間——為工廠本身撰寫單元測試。一個會默默產生重複資料的工廠會造成看起來完全像是應用程式錯誤的失敗,你會在錯誤的程式碼庫中花上好幾小時才懷疑到它。斷言「2000 個產生的 email 都是唯一的」只需要三十毫秒,並能消除這一整類的混亂。
3. 每個測試都重新登入一次
這不完全是不穩定,但它會讓其他問題更加惡化。如果每個測試一開始都要填寫登入表單,你就要為每個測試付出三到五秒,並給自己額外一百次機會在這個最常執行的流程上碰到計時失敗。
修復方式:登入一次,儲存 session,重複使用它。
建立一個設定專案:
// tests/auth.setup.ts
setup('authenticate', async ({ page }) => {
  await page.goto('/login');
  await page.getByLabel('Username').fill(process.env.TEST_USERNAME!);
  await page.getByLabel('Password').fill(process.env.TEST_PASSWORD!);
  await page.getByRole('button', { name: 'Login' }).click();

  await expect(page.getByRole('link', { name: 'Logout' })).toBeVisible();
  await page.context().storageState({ path: 'playwright/.auth/user.json' });
});
Enter fullscreen mode
Exit fullscreen mode
將它設定為相依性:
projects: [
  { name: 'setup', testMatch: /.*.setup.ts/ },
  {
    name: 'chromium',
    use: { ...devices['Desktop Chrome'], storageState: 'playwright/.auth/user.json' },
    dependencies: ['setup'],
  },
]
Enter fullscreen mode
Exit fullscreen mode
在一個 200 個測試的套件中,這通常能為每次執行減少好幾分鐘。它通常是可取得的最大單一速度改善。
有一個細節很重要:讓設定專案大聲斷言登入確實成功。如果它默默失敗,每個下游測試都會以令人困惑的方式失敗,而你會去除錯錯誤的東西。
4. 綁定在標記而不是意義上的 Locator
await page.click('.btn-primary.submit-form > span:nth-child(2)');
Enter fullscreen mode
Exit fullscreen mode
這個今天能通過,但在下一次有開發者把東西包在 div 裡時就會壞掉。更糟糕的是,它會「默默」壞掉,因為失敗訊息完全沒有告訴你實際上發生了什麼改變。
修復方式:根據使用者感知的東西來定位。
await page.getByRole('button', { name: 'Submit order' }).click();
Enter fullscreen mode
Exit fullscreen mode
這個優先順序很穩固:
-
getByRole—— 能承受重新設計,符合使用者和螢幕閱讀器看到的內容 -
getByLabel—— 將欄位與其可存取標籤繫結 -
getByTestId—— 當標記沒有提供任何語義資訊時 - CSS/XPath —— 最後手段
還有一個值得一提的額外好處:如果 getByRole 和 getByLabel 找不到你的元素,這通常代表應用程式中存在真正的無障礙問題。你的測試套件開始免費兼作無障礙冒煙測試。
5. 在所有東西上都失敗的視覺測試
團隊加入視覺回歸測試,在每個不相關的變更上都得到失敗,然後在一個月內就把它關掉。有三個原因:
動畫。 在轉場中間拍的截圖永遠不會符合。全局停用它們:
expect: {
  toHaveScreenshot: { animations: 'disabled', maxDiffPixelRatio: 0.02 },
}
Enter fullscreen mode
Exit fullscreen mode
不同機器上的字型渲染。 macOS 和 Linux 的抗鋸齒方式不同,所以在本機產生的基準永遠不會與 CI 相符。要嘛在 Docker 內產生基準,讓每個人都與相同的渲染比較;或者保留一個小的像素容忍度。
真正動態的內容。 時間戳、頭像、廣告欄位。遮罩它們:
await expect(page).toHaveScreenshot('dashboard.png', {
  mask: [page.locator('time'), page.locator('.ad-slot')],
});
Enter fullscreen mode
Exit fullscreen mode
並且優先選擇元件層級的快照,而不是全頁面的。全頁面基準在任何地方有任何改變時都會失敗。只有結帳表單的快照只會在結帳表單改變時失敗——這才是你真正想要的訊號。
這五個問題底層的模式
這五個問題的每一個都是同樣的錯誤,只是穿著不同的衣服:將關於時機或狀態的假設編碼進去,而不是等待真正的事情發生。
固定的延遲假設了時機。硬編碼的 email 假設沒有人同時在執行。CSS 路徑 locator 假設了 DOM 的形狀。全頁面快照假設頁面上沒有其他東西會改變。
用實際的條件取代每個假設,不穩定就會消失。不是「大部分消失」——而是完全消失。不穩定的測試套件並不是瀏覽器測試的固有特性,它們是建立在假設上的測試套件的特性。
一個實際的修復順序
如果你繼承了一個不穩定的測試套件,不要重寫它。依照這個順序進行——先做最便宜且影響最大的:
-
加入 lint 規則 讓它幫你找出每一個
waitForTimeout - 加入認證快取 —— 最大的速度改善,只碰一個檔案
- 修復前三個最不穩定的測試 —— 你的 CI 歷史知道它們是哪些
- 在你碰到每個檔案時替換脆弱的 locator,而不是一次大掃除
- 當你下次碰到碰撞時加入資料產生機制
你通常從前兩項就能得到大部分的好處。
我把這些模式——加上 API 測試、CI 分片和 Docker 設定——打包成一個 Playwright 入門套件,因為我每次專案都在重複建立同樣的東西。但這篇文章裡的所有內容都可以獨立使用;它們都不需要購買任何東西。

CLAUDE.md 中的規則是一種請求。Hook 則是一種保證。將這兩者混淆是我看到最常見的設定錯誤:團隊把「永遠不要提交機密」寫成文字,然後當機密真的被提交時感到驚訝。這篇文章是我使用的區分方式:什麼該寫成文字、什麼該放在 Hook,以及決定層級的四階梯。
單句總結兩者的差異
文字設定改變模型「嘗試要做什麼」。Hook 和 CI 則改變「什麼事有可能做到」。任何絕對不能發生的事都不該放在文字中,因為文字是被取樣的,而不是被執行的。
四階執行保障階梯
對於任何你想要的規則,先問它實際上需要哪個層級:
Level 1  Linter/types/CI      確定性,捕捉大部分程式碼問題
Level 2  Hooks (PreToolUse)   在指令或檔案執行前就加以阻擋
Level 3  Scoped rules         文字,只針對符合的檔案載入
Level 4  Always-on config     文字,每一次呼叫都值得花費上下文
Enter fullscreen mode
Exit fullscreen mode
這個階梯是依照可靠性排序,而最可靠的那端是免費的(不消耗 token)。每把一條規則往下推一層,就能節省上下文並移除一種失敗模式。
什麼該放在 Hook 中
我自己設定中的具體範例:
{
  "hooks": {
    "PreToolUse": [
      { "matcher": "Bash", "command": "block-dangerous.sh" },
      { "matcher": "Edit|Write", "command": "protect-env.sh" }
    ]
  }
}
Enter fullscreen mode
Exit fullscreen mode
-
破壞性指令:
rm -rf在目標目錄外、強制推送至 main、drop table。在 PreToolUse Hook 中用正規表達式就能確定地阻擋這些行為。寫成文字的「使用 rm 時要小心」大概十次有九次有效,但你只會聽說那第十次。 -
檔案保護:
.env、金鑰、產生出的檔案。Hook 會回傳阻擋原因,然後 Agent 會自行調整。只有在嘗試的那一刻才會消耗 token。 - 格式閘道:透過 Hook 在儲存時執行 prettier/eslint,而不是在設定中寫「永遠格式化你的程式碼」。確定性、零上下文消耗。
什麼該放在文字設定中
Hook 無法決定的事,因為它們需要判斷力:
- 完成定義:在這個專案中「已驗證」代表什麼。Hook 可以執行測試;只有文字能告訴 Agent 當測試失敗時該怎麼做(修正,而不是還原並繼續)。
- 優先順序:最小的 diff 獲勝、先調查再修正、驗證後就停止。這些塑造選擇,而不是動作。
- 模型無法推斷的上下文:為什麼認證機制中有那個奇怪的 workaround、程式碼庫哪些部分是產生的、誰在使用這個 API。
陷阱:把 CI 可修正的規則放在文字中
最明顯的跡象是 CLAUDE.md 中任何以「永遠執行」或「永遠不要提交」開頭的句子。如果 CI 可以檢查,就應該讓 CI 去檢查。每把一條 linter 規則重複寫在文字中,就是把上下文浪費在機器已經保證的事情上,而且當兩者出現落差時,就是一個等待發生的矛盾。
我們的工具組把文字保留給判斷力,並把所有可檢查的事項往下推到階梯的下層。這也是為什麼驗證器會拒絕佔位符的指令檔案:重述 linter 的文字比沒有檔案還糟糕,因為它會訓練你停止閱讀自己的設定。
當你沒有 Hook 系統時
較舊的設定(純 .cursorrules、裸的 AGENTS.md)沒有 Hook 層。階梯依然適用,只是往下掉一階:CI 和 linter 負責硬性保證,文字負責判斷,而「把硬性保證寫在文字中」的落差則由 git 本身的 pre-commit hook 來涵蓋,這是每個設定都有的。
相關閱讀
- 什麼是好的 AI 程式碼規則,以及是什麼讓 Agent 忽略它們:這個區分的文字面。
- 300 行指令預算:為什麼花在文字規則上的上下文必須是值得的。
- 為你的 Agent 設定做版本控制:Hook 也該放在 git 中。
我們的工具組已預先內建這個區分:文字用於判斷,Hook 與驗證器規則用於保證,皆收錄於 AgentConfig Studio。先用 Next.js 試用這個方法:免費樣本工具組(MIT)。
https://dev.to/piekwerk/config-files-vs-hooks-where-agent-enforcement-actually-belongs-2gi8
邊界限制最先失敗。不是模型。不是 schema。是上限。我不再詢問代理是否「真的在思考」,而是開始問一個更笨的問題,這個問題依然能見血。如果工具掛起,這個 while 會永遠停不下來嗎?
這個問題不浪漫。它也是讓共享的箱子不會變成熱燈的那個問題。我想要一個可以在星期一重新執行的數字,而不是來自已經奉承過我的聊天記錄的感覺。
我讀過的大多數代理重試程式碼都是一個穿著風衣的迴圈。你知道那件風衣。try、except、sleep、continue,也許還有一句註解寫著「要有韌性」。沒有預算的韌性只是無上限的帳單。作者有設定嘗試次數上限嗎?他們有設定執行時間上限嗎?還是他們只限制了自己的樂觀程度?
我做了一個評分器。不是排行榜。是一個有意見的 lint。它讀取 Python,遍歷 AST,並以我希望程式碼審查能做到的方式為重試輔助函式評分:邊界限制優先,詩意永遠不要。產出物才是重點。如果你把這篇文章裡的所有產品名稱都刪掉,你應該還是能儲存檔案並得到相同的整數。
揭露:本文是作為 MonkeyCode 的產品推廣所準備。
當我需要一個我在晚上 11 點不想手寫的候選迴圈時,我會透過 MonkeyCode 詢問一個免費模型。然後我把輸出丟進 fixtures/,並拒絕信任它,直到評分器印出分數為止。免費伺服器選項不是那個步驟的吉祥物。它是實驗的後半段,是 time.sleep 遇到排程雜訊的那一半。我的筆電是個糟糕的證人。它太快了,而且它喜歡我。
我實際編碼的評分標準
我不評「推理品質」。我評的是你即將部署的產出物中是否存在停止條件。它們是不同的論文。其中一篇是主題演講。另一篇是單元測試。
重試輔助函式從零開始。我為嘗試次數上限、執行時間逾時、退避、抖動,以及隨請求一起傳遞的冪等性金鑰加分。我為沒有中斷預算的 while True,以及無法看到截止時間的 sleep 扣分。這很嚴苛嗎?很好。一個能活得比你的耐心還久的迴圈並不穩健。它是一條塗層被剝掉的保險絲。
將此儲存為 loop_hygiene.py。它是整個靜態的一半。
#!/usr/bin/env python3
"""Score retry-loop hygiene from Python source. Fixture-calibrated, not a bake-off."""
from __future__ import annotations

import ast
import json
import sys
from dataclasses import asdict, dataclass, field
from pathlib import Path

ATTEMPT_NAMES = {"max_attempts", "max_retries", "retries", "attempts", "n_tries"}
TIMEOUT_NAMES = {"timeout", "deadline", "max_seconds", "wall_timeout", "budget_s"}
BACKOFF_NAMES = {"backoff", "backoff_s", "delay", "base_delay"}
JITTER_NAMES = {"jitter", "jitter_s", "jitter_ratio"}
IDEM_NAMES = {"idempotency_key", "idempotency", "request_id", "dedupe_key"}


@dataclass
class LoopScore:
    path: str
    has_max_attempts: bool = False
    has_timeout: bool = False
    has_backoff: bool = False
    has_jitter: bool = False
    has_idempotency: bool = False
    unbounded_while: bool = False
    sleep_without_budget: bool = False
    score: int = 0
    notes: list[str] = field(default_factory=list)


class HygieneVisitor(ast.NodeVisitor):
    def __init__(self) -> None:
        self.names: set[str] = set()
        self.unbounded_while = False
        self.sleep_calls = 0
        self.breaks_in_loop = 0

    def visit_Name(self, node: ast.Name) -> None:
        self.names.add(node.id)
        self.generic_visit(node)

    def visit_While(self, node: ast.While) -> None:
        constant_true = (
            isinstance(node.test, ast.Constant) and node.test.value is True
        ) or (
            isinstance(node.test, ast.Constant) and node.test.value == 1
        )
        if constant_true:
            self.unbounded_while = True
        for child in ast.walk(node):
            if isinstance(child, ast.Break):
                self.breaks_in_loop += 1
        self.generic_visit(node)

    def visit_Call(self, node: ast.Call) -> None:
        func = node.func
        name = ""
        if isinstance(func, ast.Attribute):
            name = func.attr
        elif isinstance(func, ast.Name):
            name = func.id
        if name in {"sleep", "usleep"}:
            self.sleep_calls += 1
        self.generic_visit(node)


def score_source(path: Path, src: str) -> LoopScore:
    tree = ast.parse(src)
    v = HygieneVisitor()
    v.visit(tree)
    row = LoopScore(path=str(path))
    row.has_max_attempts = bool(ATTEMPT_NAMES & v.names)
    row.has_timeout = bool(TIMEOUT_NAMES & v.names)
    row.has_backoff = bool(BACKOFF_NAMES & v.names)
    row.has_jitter = bool(JITTER_NAMES & v.names)
    row.has_idempotency = bool(IDEM_NAMES & v.names)
    row.unbounded_while = v.unbounded_while and v.breaks_in_loop == 0
    budget = row.has_max_attempts or row.has_timeout
    row.sleep_without_budget = v.sleep_calls > 0 and not budget

    n = 0
    if row.has_max_attempts:
        n += 2
        row.notes.append("+2 attempt cap")
    if row.has_timeout:
        n += 2
        row.notes.append("+2 wall clock")
    if row.has_backoff:
        n += 1
        row.notes.append("+1 backoff")
    if row.has_jitter:
        n += 1
        row.notes.append("+1 jitter")
    if row.has_idempotency:
        n += 2
        row.notes.append("+2 idempotency key")
    if row.unbounded_while:
        n -= 3
        row.notes.append("-3 unbounded while")
    if row.sleep_without_budget:
        n -= 2
        row.notes.append("-2 sleep with no ceiling")
    row.score = n
    return row


def main(argv: list[str]) -> int:
    root = Path(argv[1] if len(argv) > 1 else "fixtures")
    rows = []
    for path in sorted(root.glob("*.py")):
        rows.append(score_source(path, path.read_text(encoding="utf-8")))
    print(json.dumps([asdict(r) for r in rows], indent=2))
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv))
進入全螢幕模式
退出全螢幕模式
像測試一樣執行它,而不是像示範一樣。
mkdir -p fixtures
python3 loop_hygiene.py fixtures/
進入全螢幕模式
退出全螢幕模式
如果該指令沒有印出任何東西,你得到的是一個空資料夾,而不是及格的分數。空也不是有韌性。
四個測試檔,四個我能捍衛的數字
我用四個我故意寫的檔案來校準評分器。這不是關於任何具名模型的宣稱。這是宣稱當我彎曲它時,尺不會彎曲。兩個測試檔是當你說「讓它穩健」時,聊天視窗會吐出的「在 PR 看起來沒問題」的迴圈。另外兩個是我實際願意放在會呼叫我的 cron 下的迴圈。
fixtures/a_trench_coat.py 就是那件風衣。
import time

def call_tool(url):
    while True:
        try:
            return fetch(url)
        except Exception:
            time.sleep(1)
進入全螢幕模式
退出全螢幕模式
fixtures/b_range_but_naked.py 看起來有邊界,直到你注意到請求可能被收取兩次。
import time

def call_tool(url):
    max_attempts = 5
    for _ in range(max_attempts):
        try:
            return fetch(url)
        except Exception:
            time.sleep(0.5)
    raise RuntimeError("gave up")
進入全螢幕模式
退出全螢幕模式
fixtures/c_budget.py 終於承認時間的存在。
import random, time

def call_tool(url, timeout=8.0):
    max_attempts = 5
    backoff = 0.2
    deadline = time.monotonic() + timeout
    for attempt in range(max_attempts):
        if time.monotonic() >= deadline:
            raise TimeoutError("wall clock")
        try:
            return fetch(url)
        except Exception:
            jitter = random.random() * 0.05
            sleep_for = min(backoff, max(0.0, deadline - time.monotonic()))
            time.sleep(sleep_for + jitter)
            backoff *= 2
    raise RuntimeError("attempts exhausted")
進入全螢幕模式
退出全螢幕模式
fixtures/d_idempotent.py 是我實際會在審查中主張的那一個。
import random, time, uuid

def call_tool(url, timeout=8.0, idempotency_key=None):
    max_attempts = 5
    backoff = 0.2
    jitter = 0.05
    deadline = time.monotonic() + timeout
    key = idempotency_key or str(uuid.uuid4())
    for attempt in range(max_attempts):
        if time.monotonic() >= deadline:
            raise TimeoutError("wall clock")
        try:
            return fetch(url, headers={"Idempotency-Key": key})
        except Exception:
            sleep_for = min(backoff, max(0.0, deadline - time.monotonic()))
            time.sleep(sleep_for + random.random() * jitter)
            backoff *= 2
    raise RuntimeError("attempts exhausted")
進入全螢幕模式
退出全螢幕模式
在我的機器上,針對這四個檔案,評分器印出的分數是 -5, 2, 6, 8。再讀一次。風衣不是「有點草率」。它是負分。審查者喜歡的 range 迴圈得到 2 分,因為它記住了 max_attempts,卻立刻忘記了時間、抖動和重複的副作用。有預算的迴圈是 6 分。冪等的那个是 8 分。這個差距就是實驗在運作。如果你的尺無法分辨保險絲和暖氣機,你只是在收集軼事。
我會部署得到 2 分的程式嗎?不會部署在我沒有監視的箱子上。我會說得到 8 分的程式已可投入生產嗎?還是會說不。一個 AST 訪問器無法看到隱藏在好看標頭名稱後面的非冪等 POST。這個數字是一道閘門,不是一枚勳章。
我實際貼上的提示詞
當我去煩一個免費模型時,我不會叫它「寫一個穩健的代理」。那個提示詞就是你得到風衣的方式。我會要求一個函式,其合約是評分器能看見的。
Write a Python function call_tool(url, timeout=8.0, idempotency_key=None)
that retries a failing fetch(). Requirements:
- max_attempts is an int cap
- timeout is a wall-clock budget using time.monotonic()
- exponential backoff plus jitter
- send Idempotency-Key on every attempt
- no while True
Return only the function.
進入全螢幕模式
退出全螢幕模式
然後我把回傳的任何東西存成 fixtures/model_candidate.py 並執行相同的指令。我不會先讀程式碼周圍的文字。先看整數。如果這聽起來很無禮,請問問自己,為什麼一個重試輔助函式值得擁有單元測試所沒有的禮貌。
模型有加入抖動,還是只是把 sleep(1) 穿上一件更漂亮的外套?它有命名 timeout 卻從未查詢時鐘嗎?名稱很便宜。訪問器更便宜。這就是整個把戲。
我的筆電一直在撒謊的那一半
靜態分數能抓住缺少上限的情況。它們抓不到紙面上存在、卻在真實延遲面前落敗的上限。所以我加入了一個動態探測。它故意很醜。一個模擬工具會在 0.25 秒、1 秒、3 秒後回應,然後就永遠不回應。被測試的迴圈必須尊重 max_attempts 和執行時間上限,而且行程必須結束。
#!/usr/bin/env python3
"""Dynamic probe. Label: run this; do not treat my laptop timings as yours."""
import threading
import time
from http.server import BaseHTTPRequestHandler, HTTPServer

DELAYS = [0.25, 1.0, 3.0, 999.0]
HITS = {"n": 0}

class SlowTool(BaseHTTPRequestHandler):
    def do_GET(self):
        i = min(HITS["n"], len(DELAYS) - 1)
        HITS["n"] += 1
        time.sleep(DELAYS[i])
        self.send_response(200)
        self.end_headers()
        self.wfile.write(b"ok")

    def log_message(self, fmt, *args):
        return

def main() -> None:
    server = HTTPServer(("127.0.0.1", 8765), SlowTool)
    t = threading.Thread(target=server.serve_forever, daemon=True)
    t.start()
    deadline = time.monotonic() + 10.0
    # Import YOUR candidate here and call it against http://127.0.0.1:8765/
    # If this process is still alive past deadline, the loop has no ceiling.
    while time.monotonic() < deadline:
        time.sleep(0.05)
    server.shutdown()
    print({"hits": HITS["n"], "exited_before_watchdog": True})

if __name__ == "__main__":
    main()
進入全螢幕模式
退出全螢幕模式
在我的筆電上,3 秒的延遲是一個禮貌的暫停。在共享的免費伺服器上,那個暫停會與其他人的工作以及箱子實際擁有的任何監控程式發生碰撞。如果你的停止條件是「我看轉圈看膩了」,伺服器不會替你看膩。這就是為什麼免費伺服器應該屬於這個方法,而不是屬於一句口號。延遲是證人。安靜的 SSD 是被告的朋友。
我不會為那一半發布對抗賽表格,因為我不會捏造模型名稱、硬體規格或永久性宣稱。協定就是結果。你讓候選程式對抗模擬工具。要嘛行程在 10 秒監控程式之前結束,不然你就是剛剛看著一個無邊界迴圈花掉別人的電。你希望被哪個結果驚訝,是整數還是生產環境?
這沒有測量的事
這沒有測量一個模型是否「比大多數開發者更會寫程式」。我完全不知道你怎麼抽樣那句話而不對自己說謊。它沒有測量 MCP 伺服器、社群知識庫,或代理是否其實是 if 陳述式。很多 if 陳述式都很誠實。不誠實的是那些拒絕成為帶有計數器的 if 陳述式的迴圈。
AST 評分器是一支手電筒。它會錯過藏在 exec、我沒有命名的裝飾器,或是因為有人認為那是架構而重新啟動自己的子行程中的重試。免費模型輸出會變化。免費伺服器不是 SLO。如果你需要固定的模型身分、保留的 CPU,或是會標明延遲的廠商合約,不要使用這個工作流程。請使用付費的、具名的端點,以及一個你可以 SSH 進去而不用猜測還有誰在同一台機器上的箱子。
誰應該跳過它:任何在出貨計費、醫療保健,或是圍繞非冪等收費的重試的人。8 分的衛生分數不是 PCI 稽核。如果你不打算閱讀產生的迴圈,也請跳過它。一個你忽略的評分器只是另一個儀表板,而儀表板不會在發票來之前呼叫你。
我仍然會在爭論「代理品質」之前先執行評分器。邊界限制在聊天中是可選的。在行程表中卻不是。如果你希望動態的那一半在不是你筆電的機器上變得醜陋,我已經把那個探測放在 MonkeyCode 的免費伺服器上,並讓延遲保持不誠實。先偷走這個測試架構。再來和我爭論評分標準。
https://dev.to/hackhub_6179/i-scored-retry-loops-boundedness-was-optional-pe7
https://www.worldprogramming.org/posts/i-scored-retry-loops-boundedness-was-optional-uihs26
然而,它認為恐懼會扭曲實際局勢。「我們的核心論點是,AI 週期正從『建置容量』轉向『證明回報』——這一轉型本質上偏重服務,並直接發揮印度 IT 在部署、整合、治理與舊系統現代化方面的優勢,」它表示。
該券商表示,價值正從資助 AI 建置的層級轉移到部署 AI 的層級。首先是企業軟體平台,接著是整合與運營這些平台的服務公司。
它表示,這就像雲端劇本重演:資本支出先行,報酬後至,惠及不同參與者,如同鐵路、光纖與 2015-19 年的雲端 J 曲線所見。以下是該券商對其五大 IT 股票推薦所給予的目標價與看法。
Tech Mahindra
Anand Rathi 表示,Tech Mahindra 即將進入 FY27,這是其三年轉型計劃的最後一年,驅動因素從毛利率恢復轉向高於同業的營收成長,背後有自計劃啟動以來最強勁的一季、加速的訂單動能、健康的訂單簿(企業需求無明顯惡化)、涵蓋顧問、平台、工程與夥伴關係的 Project Helix,以及其 Agentic Development & Modernization Services 產品組合。
LTM
Anand Rathi 表示,LTM 獲得強勁營收成長能見度支持,來自大型交易動能、關鍵 BFSI 與最大客戶帳戶的復甦、透過 Randstad 收購案在歐洲的策略擴張、Lakshya’31 成長策略的執行,以及透過提高股利支付比率來增加股東回報的空間。
Infosys
Anand Rathi 表示,Infosys 的 FY27 預計表現平淡;然而 BFSI(占 28%)與 EURS(占 13%)應會表現良好。FY28 預計將因 LTM 第一季大型交易 TCV 成長 30% 而改善,Anand Rathi 表示。AI 貨幣化上升(占營收 8.2%,從第三季到第一季 CQGR 成長 22%),加上 Topaz Fabric/Cobalt 與平台主導的收購案,預計將支持成長與毛利率。FY26-28E 調整後 EPS CAGR 為 7.8%,股利收益率 4.2%,FCF 收益率 8.1%,調整後 PEG 為 1.9 倍,提供估值支撐。
Persistent Systems
Persistent 仍處於領先業界成長的良好定位,受惠於透過 Sasva 與 iAURA 等平台強勁的 AI 主導執行、嚴謹的執行、在 BFSI(占營收 34%)與醫療保健(占營收 25%)加速的需求,以及擬議中的 Nagarro 收購案,該收購將擴大其歐洲布局、可觸及市場與長期成長機會。
Mphasis
Mphasis 定位良好,可搶占市占率,受惠於創紀錄高的業務管道(年增 28%),其中 AI 主導交易如今占約 70%,相較於 Mphasis AI 推出時的約 12%。此外,還有更高的穩態 TCV 基線、透過 Neo IP、Continuum AI 與 Tria 的平台主導執行,以及透過成果導向模式改善獲利能力。
Disclaimer: Business Today provides stock market news for informational purposes only and should not be construed as investment advice. Readers are encouraged to consult with a qualified financial advisor before making any investment decisions.

標題:平行路由讓 Next.js App Router 的 layout 透過名為
@slot的資料夾,在同一個 URL 下能同時渲染多個頁面,而攔截路由((.)、(..)、(..)(..)和(...)資料夾慣例)則讓連結可以在不改變 URL 的情況下,將該 slot 替換成不同的元件。兩者結合後,就能實現 Instagram 風格的可分享相片 Modal:同一個 URL 在軟性導航時顯示 Modal,在硬性重新整理時則顯示完整頁面,而default.tsx就是兩者之間的接縫。
關鍵重點
- 平行路由是一個具名的 slot —— 以
@為前綴的資料夾,例如@modal—— Next.js 會將其渲染為 prop,傳入最接近的layout.tsx,與隱含的childrenslot 並存。Slot 資料夾不會為 URL 增加片段。 - 攔截路由慣例(
(.)、(..)、(..)(..)、(...))是相對於檔案系統而非 URL 來匹配路由,因此從動態消息中點擊的連結,可以將/photo/[id]渲染為 Modal,而 URL 中永遠不會出現名為(.)photo的資料夾。 default.tsx是當目前 URL 在該 slot 內沒有任何匹配時,Next.js 會為該 slot 渲染的內容。如果省略它,當硬性導航到一個沒有填滿所有 slot 的路由時,就會出現 404。- 對
/photo/123進行硬性重新整理或分享連結時,不應該顯示 Modal —— 而是應該渲染app/photo/[id]/page.tsx作為一般的完整頁面。這個後備機制才是這個模式的真正目的,而不是需要繞開的 bug。 - 每個 slot 都是擁有自己
loading.tsx和error.tsx的獨立子樹,因此 Modal 可以獨立於後方頁面的渲染進行暫停與串流。
平行路由實際上解決了什麼問題?
平行路由可以在同一個 layout 中同時渲染多個頁面,每個頁面都由一個具名 slot 而非 URL 片段來定址。我第一次使用它是在一個相片網格中:點擊縮圖應該在不離開網格的情況下開啟燈箱,但燈箱也需要有自己的可分享 URL,以便直接連結到單張相片就能開啟完整頁面。由布林值驅動的客戶端 Modal 能免費獲得前半部分,但完全無法做到後半部分 —— 因為 useState 中的狀態沒有對應的 URL。
資料夾慣例是加上 @ 前綴的名稱。Next.js 會將每個 slot 匹配到的內容,以資料夾名稱為 prop 名稱,傳入最接近的 layout,與每個 layout 原本就會收到的隱含 children slot 並存。
app/
  layout.tsx
  page.tsx
  @modal/
    default.tsx
    (.)photo/
      [id]/
        page.tsx
  photo/
    [id]/
      page.tsx
進入全螢幕模式
退出全螢幕模式
// app/layout.tsx
export default function RootLayout({
  children,
  modal,
}: {
  children: React.ReactNode;
  modal: React.ReactNode;
}) {
  return (
    <html lang="en">
      <body>
        {children}
        {modal}
      </body>
    </html>
  );
}
進入全螢幕模式
退出全螢幕模式
這裡的內容還沒有任何與 Modal 相關的特定設計 —— 一個擁有兩個 slot 的 layout 只是能渲染兩個獨立子樹的 layout。我後來也用相同的機制來實作一個儀表板,包含可以獨立導航的 @team 和 @analytics 面板:在 @analytics 內點擊連結只會重新渲染該 slot,而 @team 則會繼續顯示原本的內容。
(.) 慣例如何決定要攔截什麼?
這些點號片段慣例是相對於攔截檔案在檔案系統中的位置來匹配目標路由,而不是相對於目前的 URL:
| 慣例 | 匹配對象 |
|---|---|
(.) |
同一層資料夾的路由 |
(..) |
上一層資料夾的路由 |
(..)(..) |
上兩層資料夾的路由 |
(...) |
從 app 根目錄開始的路由 |
app/@modal/(.)photo/[id]/page.tsx 會攔截對 /photo/[id] 的客戶端導航,只要該導航是從與 @modal 資料夾處於同一層的路由觸發的。從該頁面追蹤 <Link href="/photo/123">,Next.js 就會將攔截的元件渲染到 @modal slot 中,而不是替換整個樹。將 /photo/123 作為全新頁面載入(重新整理、貼上 URL、從外部網站點擊連結)時,Next.js 會以一般方式解析 app/photo/[id]/page.tsx。攔截只會在客戶端轉場時觸發;它從來就不是用來改變完整頁面載入的回應內容。
為什麼需要 default.tsx?如果跳過它會發生什麼事?
我第一次跳過它時,在開發環境中一切正常,直到我在開啟 Modal 的路由上重新整理後得到了 404。當一個 slot 在目前 URL 下沒有匹配的片段時,它需要有東西可以渲染,而在完整頁面載入時,沒有先前的客戶端狀態可以回退 —— Next.js 必須從頭開始渲染該 slot。default.tsx 就是這個後備機制。
// app/@modal/default.tsx
export default function Default() {
  return null;
}
進入全螢幕模式
退出全螢幕模式
客戶端導航則比較寬容:如果一個 slot 沒有 default.tsx,且新的 URL 在其中沒有任何匹配,Next.js 會繼續渲染該 slot 上次顯示的內容,而不是將其卸載。這對於儀表板分頁的案例非常有用 —— 在 @analytics 中切換分頁不應該重置 @team —— 但這也意味著缺少 default.tsx 可能在每次手動點擊測試中都隱藏起來,只有在硬性重新載入時才會浮現,而這正是分享連結所採用的路徑。
為什麼重新整理 Modal 路由會顯示完整頁面而不是 Modal?
因為它本來就應該這樣。這是我在正確理解這個模式之前一直抗拒的部分:我想要 Modal 能在重新整理後繼續存在,但實際的設計是它不應該繼續存在。app/photo/[id]/page.tsx 是一個完整的、獨立的頁面 —— 相同的內容、沒有 Modal 的外觀,而且不需要先執行任何客戶端 JavaScript 就能存取。這才是讓 URL 真正可分享且可被索引的原因:搜尋引擎或不執行你客戶端路由器的連結預覽機器人,會得到真正的頁面,而不是一個等待 JavaScript 開啟對話框的空殼。
如何關閉 Modal 並回到原本的位置?
Modal 元件是一個客戶端元件,它會呼叫來自 next/navigation 的 router.back(),這會反轉開啟它的軟性導航,讓被攔截的 slot 回退到它的 default.tsx。
'use client';
import { useRouter } from 'next/navigation';

export function Modal({ children }: { children: React.ReactNode }) {
  const router = useRouter();
  return (
    <div className="modal-overlay" onClick={() => router.back()}>
      <div className="modal-content" onClick={(e) => e.stopPropagation()}>
        {children}
      </div>
    </div>
  );
}
進入全螢幕模式
退出全螢幕模式
我在正式環境中發現的缺口是:如果訪客從分享的連結直接在新分頁中開啟 /photo/123,就沒有歷史記錄可以返回,因此 router.back() 要嘛什麼都不做,要嘛離開應用程式。我最後在疊加層處理程式旁邊加上了一個明確的關閉連結,指向一個真正的返回相簿的 href,這樣關閉 Modal 就不再依賴歷史記錄是否存在。
客戶端狀態 Modal 與攔截路由 Modal —— 真正的權衡是什麼?
| 布林狀態 Modal | 攔截路由 Modal | |
|---|---|---|
| 擁有自己的 URL | 否 | 是 |
| 可分享 / 重新整理時顯示 | 否 | 是 —— 渲染為完整頁面 |
| 是否需要客戶端 JS 才能渲染內容 | 是 | 否(直接導航時) |
| 設定成本 | 一個 useState
|
一個 slot、一個攔截資料夾、一個後備路由、default.tsx
|
對於真正屬於一次性 UI 的對話框(例如確認提示、設定面板),布林值仍然是正確的工具。只有當 Modal 後方的內容值得擁有自己的 URL 時,才應該選擇路由版本。
常見問題
問:像 @modal 這樣的平行路由 slot 資料夾會出現在 URL 中嗎?
答:不會。@ 前綴會將資料夾標記為 slot 而非路由片段,因此它對 URL 是隱形的,只會影響 layout 的哪一個 prop 會收到它的內容。
問:如果有人不是從動態消息中的縮圖點擊,而是直接導航到 /photo/123,會發生什麼?
答:Next.js 會將 app/photo/[id]/page.tsx 渲染為一般的完整頁面。攔截只會在從匹配路由進行的客戶端轉場時發生,這是設計上的意圖。
問:平行路由 slot 可以有自己的 loading.tsx 嗎?
答:可以。每個 slot 都是獨立的子樹,可以定義自己的 loading.tsx、error.tsx 和 not-found.tsx,因此 Modal 可以獨立於後方頁面進行資料擷取的暫停,而不會阻擋後方的頁面。
問:為什麼 router.back() 無法為直接開啟連結的人關閉 Modal?
答:當一個路由是分頁中第一個載入的內容時,就沒有歷史記錄可以返回。請將關閉處理程式與指向真實後備路由的明確連結搭配使用,而不是只依賴歷史記錄。
問:我可以將 (..)(..) 與定義在樹上更高層的平行路由 slot 結合使用嗎?
答:可以 —— 點號的數量與 @slot 資料夾所在的位置無關;它只描述目標路由相對於攔截檔案自身位置往上幾層。
原文發表於 devya.dev。也刊登於 eng-ahmed.com。由 Devya Solutions 建置。

我正在使用 Rust 與 Python 開發開源 MMORPG — 正在尋找貢獻者
大家好!👋
我目前正在開發The Last Signal,這是一個開源的末日後 MMORPG 專案。
這個專案以Rust 和 Python為基礎,特別注重網路、伺服器架構、測試,並最終建構一個持久化的多人遊戲世界。
專案仍在開發階段,因此有許多部分可以探索、改進和建構。
🎮 什麼是 The Last Signal?
我們的目標是打造一個多人末日後世界,讓玩家能夠探索、互動、戰鬥、交易,並創造屬於自己的故事。
我目前並非一次建構所有功能,而是專注於開發專案的基礎:客戶端與伺服器之間的通訊、封包處理、測試、CI 以及整體架構。
🛠️ 目前使用的技術
- 🦀 Rust — 伺服器與網路相關元件
- 🐍 Python — 客戶端與工具
- 🌐 客戶端/伺服器網路通訊
- 📦 自訂網路封包系統
- 🧪 自動化測試
- ⚙️ GitHub Actions / CI
- 🗄️ 資料庫元件
- 🔐 實驗性加密 — 目前仍處於非常早期的階段
🌐 網路部分
目前其中一個技術重點是 Python 客戶端與 Rust 伺服器之間的通訊。
專案擁有自己的封包系統,使用不同類型的封包在兩端之間進行通訊。
我目前正在處理的事項包括:
- 封包建立
- 序列化與反序列化
- 處理無效資料
- 網路錯誤處理
- 測試通訊協定
- 保持客戶端與伺服器實作的一致性
這是 Rust 貢獻者可以對專案產生直接影響的領域之一。
🔐 加密功能才剛起步
專案的加密部分非常實驗性且仍處於早期階段。
我正在嘗試各種想法,並探索加密系統如何融入這個專案。
目前並非以生產環境可用或安全的加密方式呈現。
我實際上正在尋找能夠挑戰設計、找出弱點與假設,並幫助判斷哪些方法值得進一步探索的人。
對密碼學、密碼分析或安全性有興趣的人在這裡會非常受到歡迎。
🤝 我正在尋找貢獻者
我目前正在尋找有興趣參與開源專案的人。
🦀 Rust 開發者
協助以下領域:
- 網路
- 封包處理
- 伺服器開發
- 測試
- 錯誤處理
- 架構
- 效能
🐍 Python 開發者
協助以下事項:
- 客戶端開發
- 測試
- 工具
- 自動化
- 與 Rust 伺服器的通訊
🔐 安全性 / 加密貢獻者
加密工作才剛開始。
可能的貢獻包括:
- 審核實驗性設計
- 找出安全性假設
- 發現潛在弱點
- 研究替代方法
- 設計安全性測試
- 討論實驗與現實世界加密之間的界線
你不需要立即撰寫加密程式碼。一份好的技術分析已經是非常有價值的貢獻。
📚 文件貢獻者
協助讓新開發者更容易理解專案:
- 架構文件
- 網路協定文件
- 開發者指南
- 英文文件
⚙️ CI/CD 貢獻者
專案也有 GitHub Actions 工作流程,可以進行改進與維護。
歡迎參與以下事項:
- 測試
- 建置工作流程
- 自動化
- 可靠性
- 效能
的貢獻。
🧪 你可以從哪裡開始?
我已經建立了幾個 GitHub Issues,專門設計作為貢獻者的切入點。
目前的領域包括:
- 🦀 Rust 網路協定測試
- 🐍 Python 客戶端測試
- 📚 客戶端/伺服器協定文件
- 🔐 加密設計審核
- ⚙️ CI/CD 改進
- 🌍 英文文件
你不需要先理解整個專案才能貢獻。
小型貢獻也非常歡迎。
🌱 你不需要是專家
如果你正在學習 Rust 或 Python,並希望在真實的開源專案中累積經驗,歡迎前來貢獻。
我特別對喜歡以下事情的人感興趣:
- 透過真實專案學習
- 實驗技術想法
- 解決困難問題
- 討論架構
- 檢視並改進現有程式碼
你可以透過撰寫程式碼、測試、撰寫文件、檢視,或單純提供有建設性的技術回饋來貢獻。
🧠 技術回饋非常歡迎
專案還很年輕,因此我並不執著於目前的每一個實作。
如果你看到可以改進的設計,我寧願聽到有充分理由的批評,也不希望壞的設計留在專案中。
我們的目標是透過合作與討論來打造更好的東西。
🔗 專案
GitHub:
https://github.com/DDCoder23/The-last-signal-
此儲存庫包含原始碼、文件和開放的 Issues。
如果這個專案讓你感興趣,請查看儲存庫,並歡迎:
- 開啟 Issue
- 在現有 Issue 下留言
- 提出改進建議
- 提交 Pull Request
我期待認識那些想要一起學習、實驗和打造事物的人。🦀🐍🚀
感謝閱讀!
https://dev.to/ddcoder23/im-building-an-open-source-mmorpg-with-rust-python-join-the-project-2lp0
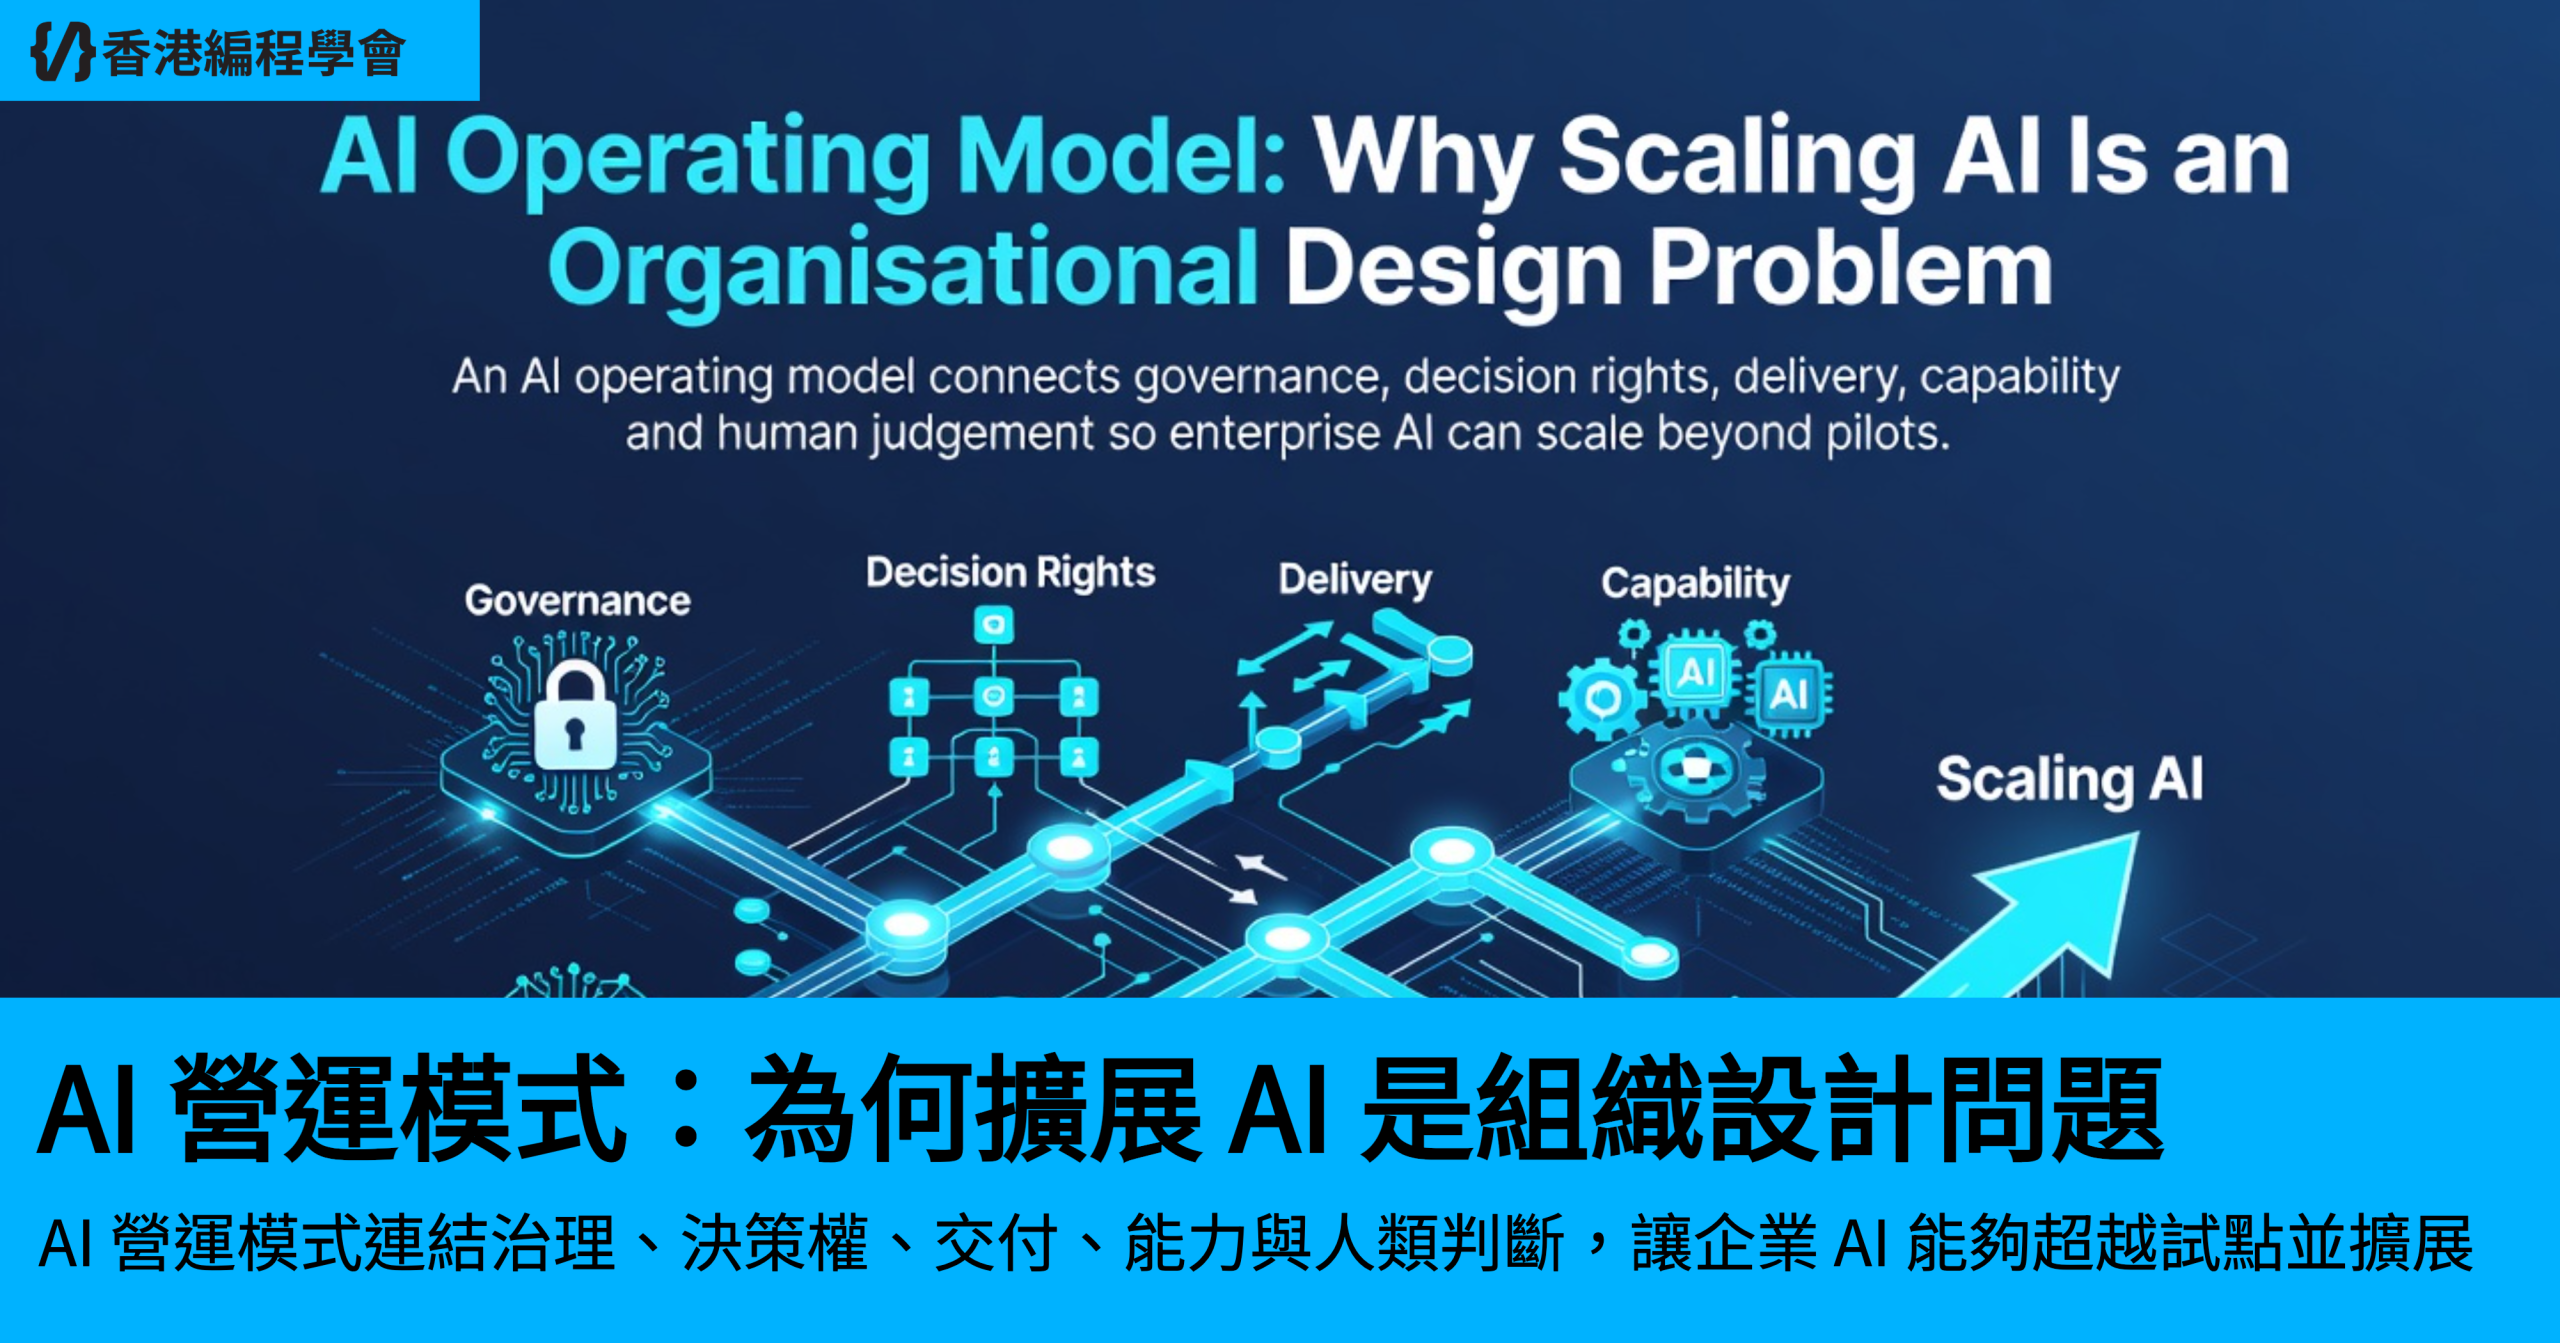
AI 採用正變得更容易。擴展 AI 則不然。
模型能力更強。API 更容易存取。Copilot 可以快速部署。團隊可以在幾天內原型化有用的工作流程。
然而許多組織仍難以將這些活動轉化為持久的能力。
原因越來越清楚:AI 無法僅透過技術來擴展。它透過營運模式來擴展。
這意味著決定誰擁有 AI、如何選擇使用案例、如何治理風險、如何分享學習、如何讓人類判斷保持在迴路中,以及如何讓成功的實驗成為日常工作的一部分。
這就是為什麼AI 營運模式這個詞正變得越來越重要。在 2026 年,Deloitte 報告了一個驚人的差距:雖然許多技術領導者相信他們能夠大規模部署和治理 AI,但近四分之三仍預期其營運模式將在 12 到 18 個月內改變。問題是從「我們能使用 AI 嗎?」轉移到「組織能否良好地吸收它?」
這是另一個不同的問題。
什麼是 AI 營運模式?
AI 營運模式是決定 AI 決策如何制定、治理、資助、建置、採用和改進的組織系統。
它不僅僅是一份 AI 策略文件。它不是 AI 治理政策。它也不是一個換了新名稱的中央 AI 團隊。
一個有用的 AI 營運模式至少連結六件事:
- 決策權 — 誰可以核准、停止或升級 AI 使用案例;
- 所有權 — 誰對業務成果負責,而不僅是模型;
- 治理 — 需要哪些證據、控制和審核;
- 交付 — 想法如何從實驗移動到正式上線;
- 能力 — 團隊如何學習良好且安全地使用 AI;
- 回饋 — 真實成果如何改變未來的 AI 決策。
技術很重要。但圍繞技術的模式決定它是否成為能力,還是停留在實驗階段。
為何 AI 試點的增加速度快於 AI 能力
大多數組織並不缺乏想法。
他們有使用案例清單。
客服想要摘要。財務想要預測。行銷想要內容加速。產品想要研究合成。工程想要編碼協助。營運想要自動化。領導想要更好的決策支援。
常見的回應是啟動試點。
試點很有用,因為它們降低了學習成本。但當每個團隊獨立進行試點時,組織可能會產生一種新的碎片化:
- 重複的工具;
- 不一致的資料處理;
- 不明確的模型所有權;
- 不同的審核標準;
- 沒有共享的評估方法;
- 沒有共同的人類監督方法;
- 成功的實驗從未成為可重複的實務。
結果可能看起來像「很多 AI」,但沒有多少機構能力。
這就是 AI 營運模式變得有用的地方。它創造了一種讓學習能夠累積而非在每個團隊中重置的方式。
每個 AI 營運模式中的三個系統
理解 AI 採用的一種方式是透過三個互動的視角:心理學、技術與組織。
這很重要,因為 AI 同時改變這三者。
1. 心理學:人們決定 AI 是否真正被使用
一個 AI 系統在技術上可能極佳,但如果人們不信任它、不了解它或不知道何時該覆寫它,它仍然會失敗。
採用受到以下問題的影響:
- 員工是否相信 AI 會幫助他們還是取代他們?
- 管理者是否了解何時應該質疑 AI 輸出?
- 人們是否願意承認模型可能出錯?
- 介面是否鼓勵驗證還是被動接受?
- 激勵措施是否與負責任的使用一致,還是僅與速度一致?
這就是為什麼「訓練」這個詞對 AI 採用來說太狹隘。
真正的問題是行為。
AI 營運模式必須創造信心而不造成自滿。它應該讓良好的判斷更容易,而不僅是讓 AI 可用。
2. 技術:系統決定 AI 可以安全地做什麼
第二層是技術性的。
AI 需要存取資料、工具、工作流程和應用程式。隨著能力增加,架構和控制的重要性也隨之增加。
因此組織需要對以下問題有明確的答案:
- 哪些模型和平台被核准?
- 每個系統可以存取哪些資料?
- 檢索、編輯或權限控制必須放在哪裡?
- 提示、輸出和模型版本如何被記錄?
- 部署前後如何評估品質?
- 當代理程式可以採取行動而不僅是產生文字時,會發生什麼?
這就是標準和風險框架重要的地方。NIST 的 AI 風險管理框架及其生成式 AI 概況強調生命週期風險管理,而 ISO/IEC 42001 將 AI 視為管理系統問題,而非一次性技術控制。
這些框架很有用,因為它們強化了一個簡單的觀點:負責任的 AI 需要圍繞技術的可重複組織流程。
3. 組織:結構決定 AI 是否成為能力
第三層是組織性的。
必須有人負責這些決策。
這聽起來很明顯,但 AI 常常跨越現有的界線。一個面向客戶的 AI 功能可能涉及產品、技術、法律、安全、資料、營運和客服。一個編碼助理可能影響工程品質、智慧財產、安全和生產力衡量。一個內部代理程式可能觸及多個團隊擁有的系統。
傳統的組織圖不會自動解決這些問題。
因此 AI 營運模式必須定義:
- 誰擁有使用案例;
- 誰擁有模型或平台決策;
- 誰擁有風險接受;
- 誰可以核准正式上線使用;
- 誰在推出後監控效能;
- 誰決定何時應該退役 AI 系統。
沒有這種明確性,治理就會變成排隊,而交付就會變成談判。
集中式還是聯邦式?通常兩者皆是
常見的 AI 營運模式問題是 AI 是否應該集中化。
集中化部分內容有充分理由。共享標準、架構、安全、評估、供應商決策和治理,如果每個業務單位獨立重建,會變得昂貴且不一致。
但集中化每個使用案例會產生另一個問題:最接近工作的人失去了所有權。
這就是為什麼許多企業 AI 模式正朝向聯邦式結構發展。
中心掌握應該共通的事項:
- 原則和政策;
- 核准的平台;
- 模型和供應商標準;
- 可重用的架構;
- 評估方法;
- 高風險審核;
- 共享知識和操作手冊。
業務和產品團隊掌握需要情境的事項:
- 問題定義;
- 工作流程設計;
- 使用者行為;
- 領域特定的品質門檻;
- 採用;
- 成果所有權。
中心不應該成為每個 AI 決策都要等待的地方。
它的職責是讓良好的分散式決策成為可能。
AI 卓越中心應該散布能力,而非收集權力
這就是卓越中心可以提供幫助的地方——如果它被正確設計。
一個弱的 AI CoE 會變成審核請求的委員會。
一個較強的則會變成讓 AI 能力可重複的組織機制。
它的角色可能包括:
- 維護共享的 AI 架構和標準;
- 定義評估和治理要求;
- 維護可重用的模式和操作手冊;
- 幫助團隊建構高價值使用案例;
- 建構內部能力;
- 連結跨部門的經驗教訓;
- 為高風險決策建立升級路徑。
測試很簡單:這個 CoE 是否讓組織更有能力,而不會讓它更依賴?
Cralgo 在其關於卓越中心和技術作為組織系統的工作中探討了這個更廣泛的能力問題。
治理必須以執行的速度前進
AI 治理常常被討論為控制問題。
它也是一個執行設計問題。
如果治理只在專案結束時發生,團隊要麼等太久,要麼繞過它。如果每個使用案例都接受相同的審核,低風險實驗會變得不必要地緩慢,而真正重要的風險可能獲得太少的關注。
更好的 AI 營運模式讓治理成比例。
例如:
低風險內部協助
使用核准企業資料的會議摘要工具可能只需要輕量級控制、明確的保留規則和基本的品質檢查。
中風險工作流程自動化
推薦營運行動的 AI 系統可能需要更強的記錄、人類核准和明確的回滾路徑。
高風險決策支援
用於醫療保健、就業、財務決策或安全敏感營運等領域的 AI 可能需要獨立驗證、記錄證據、更嚴格的監控和正式的問責。
重點不是讓治理變得更小。
而是讓治理符合決策的後果。
缺失的能力往往是判斷
隨著 AI 系統變得更有能力,組織可能會傾向於將更多決策移入系統。
但能力和權威並不相同。
一個模型可能能夠推薦行動,但不一定是擁有該行動的正確地方。
這種區別在代理程式能夠呼叫工具、更新系統、觸發工作流程或與客戶溝通時尤其重要。
關鍵的設計問題從:
AI 能做什麼?
轉變為:
AI 應該被允許做什麼,在什麼條件下,由誰的判斷圍繞它?
這就是為什麼 AI 的人類面向無法與技術面向分離。信任、注意力、決策和問責都塑造了成果。
實用的 AI 營運模式檢查清單
在組織內擴展 AI 之前,領導團隊應該能夠清楚回答這些問題:
- 我們試圖用 AI 改善哪些成果?
- 試點結束後誰擁有每個使用案例?
- 哪些 AI 能力是集中的,哪些是分散的?
- 組織內共享哪些技術標準?
- 使用案例如何依風險分類?
- 正式上線部署前需要哪些證據?
- 人類判斷在哪裡是強制性的?
- 模型效能和業務成果如何分別被監控?
- 一個團隊的學習如何成為另一團隊的可重用知識?
- 即使供應商改變,哪些能力應該留在組織內?
如果這些答案模糊,組織可能還沒有 AI 營運模式。它只有 AI 活動。
這兩者並不相同。
營運模式是將 AI 轉化為組織能力的關鍵
企業 AI 的下一個階段不會僅由誰能存取最強模型來決定。
存取正變得更容易。
更難的優勢是組織性的:良好決策、安全部署、快速學習、散布能力,以及在 AI 嵌入日常工作時保留判斷的能力。
這就是為什麼 AI 營運模式很重要。
技術改變了什麼變得可能。
人們決定它如何被理解和使用。
組織決定那個可能性是否成為可重複的能力。
成果來自這三者的結合。
Cralgo 是一家研究與技術公司,探索心理學、技術與組織如何塑造更好的成果。
探索 Cralgo、Technology,以及 Operating Model。
參考資料
- Deloitte Insights, Rewiring the enterprise operating model for AI scale (2026): https://www.deloitte.com/us/en/insights/topics/technology-management/rewiring-ai-operating-model.html
- NIST, AI Risk Management Framework: https://www.nist.gov/itl/ai-risk-management-framework
- NIST, Generative AI Profile: https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence
- ISO/IEC 42001:2023, AI management systems: https://www.iso.org/standard/42001
https://dev.to/cralgo/ai-operating-model-why-scaling-ai-is-an-organisational-design-problem-2cg9
2026 年 9 月 1 日
Ryan 與 Tim Lindholm 對談。Tim 是 Sun Microsystems 早期 Java 語言的貢獻者,他們聊了在 Java 剛誕生時打造這門史上最受歡迎的程式語言之一是什麼感覺、為什麼對 Java 團隊來說建立跨平台的 ABI 以與 Windows NT 競爭具有戰略重要性,以及 applet 最初只是個有趣的展示。

觀看 Cult.Repo 在 YouTube 推出的新紀錄片,深入了解 Java 的早期歷史以及打造它的人們。
在 LinkedIn 上與 Tim Lindholm 聯繫。
向使用者 gabuzo 致敬,他因回答 What is the standard method for generating a nonce in Python? 而獲得 Populist 徽章。
https://stackoverflow.blog/2026/09/01/the-good-ol-days-of-building-java/
https://www.worldprogramming.org/posts/the-good-ol-days-of-building-java-nuompu
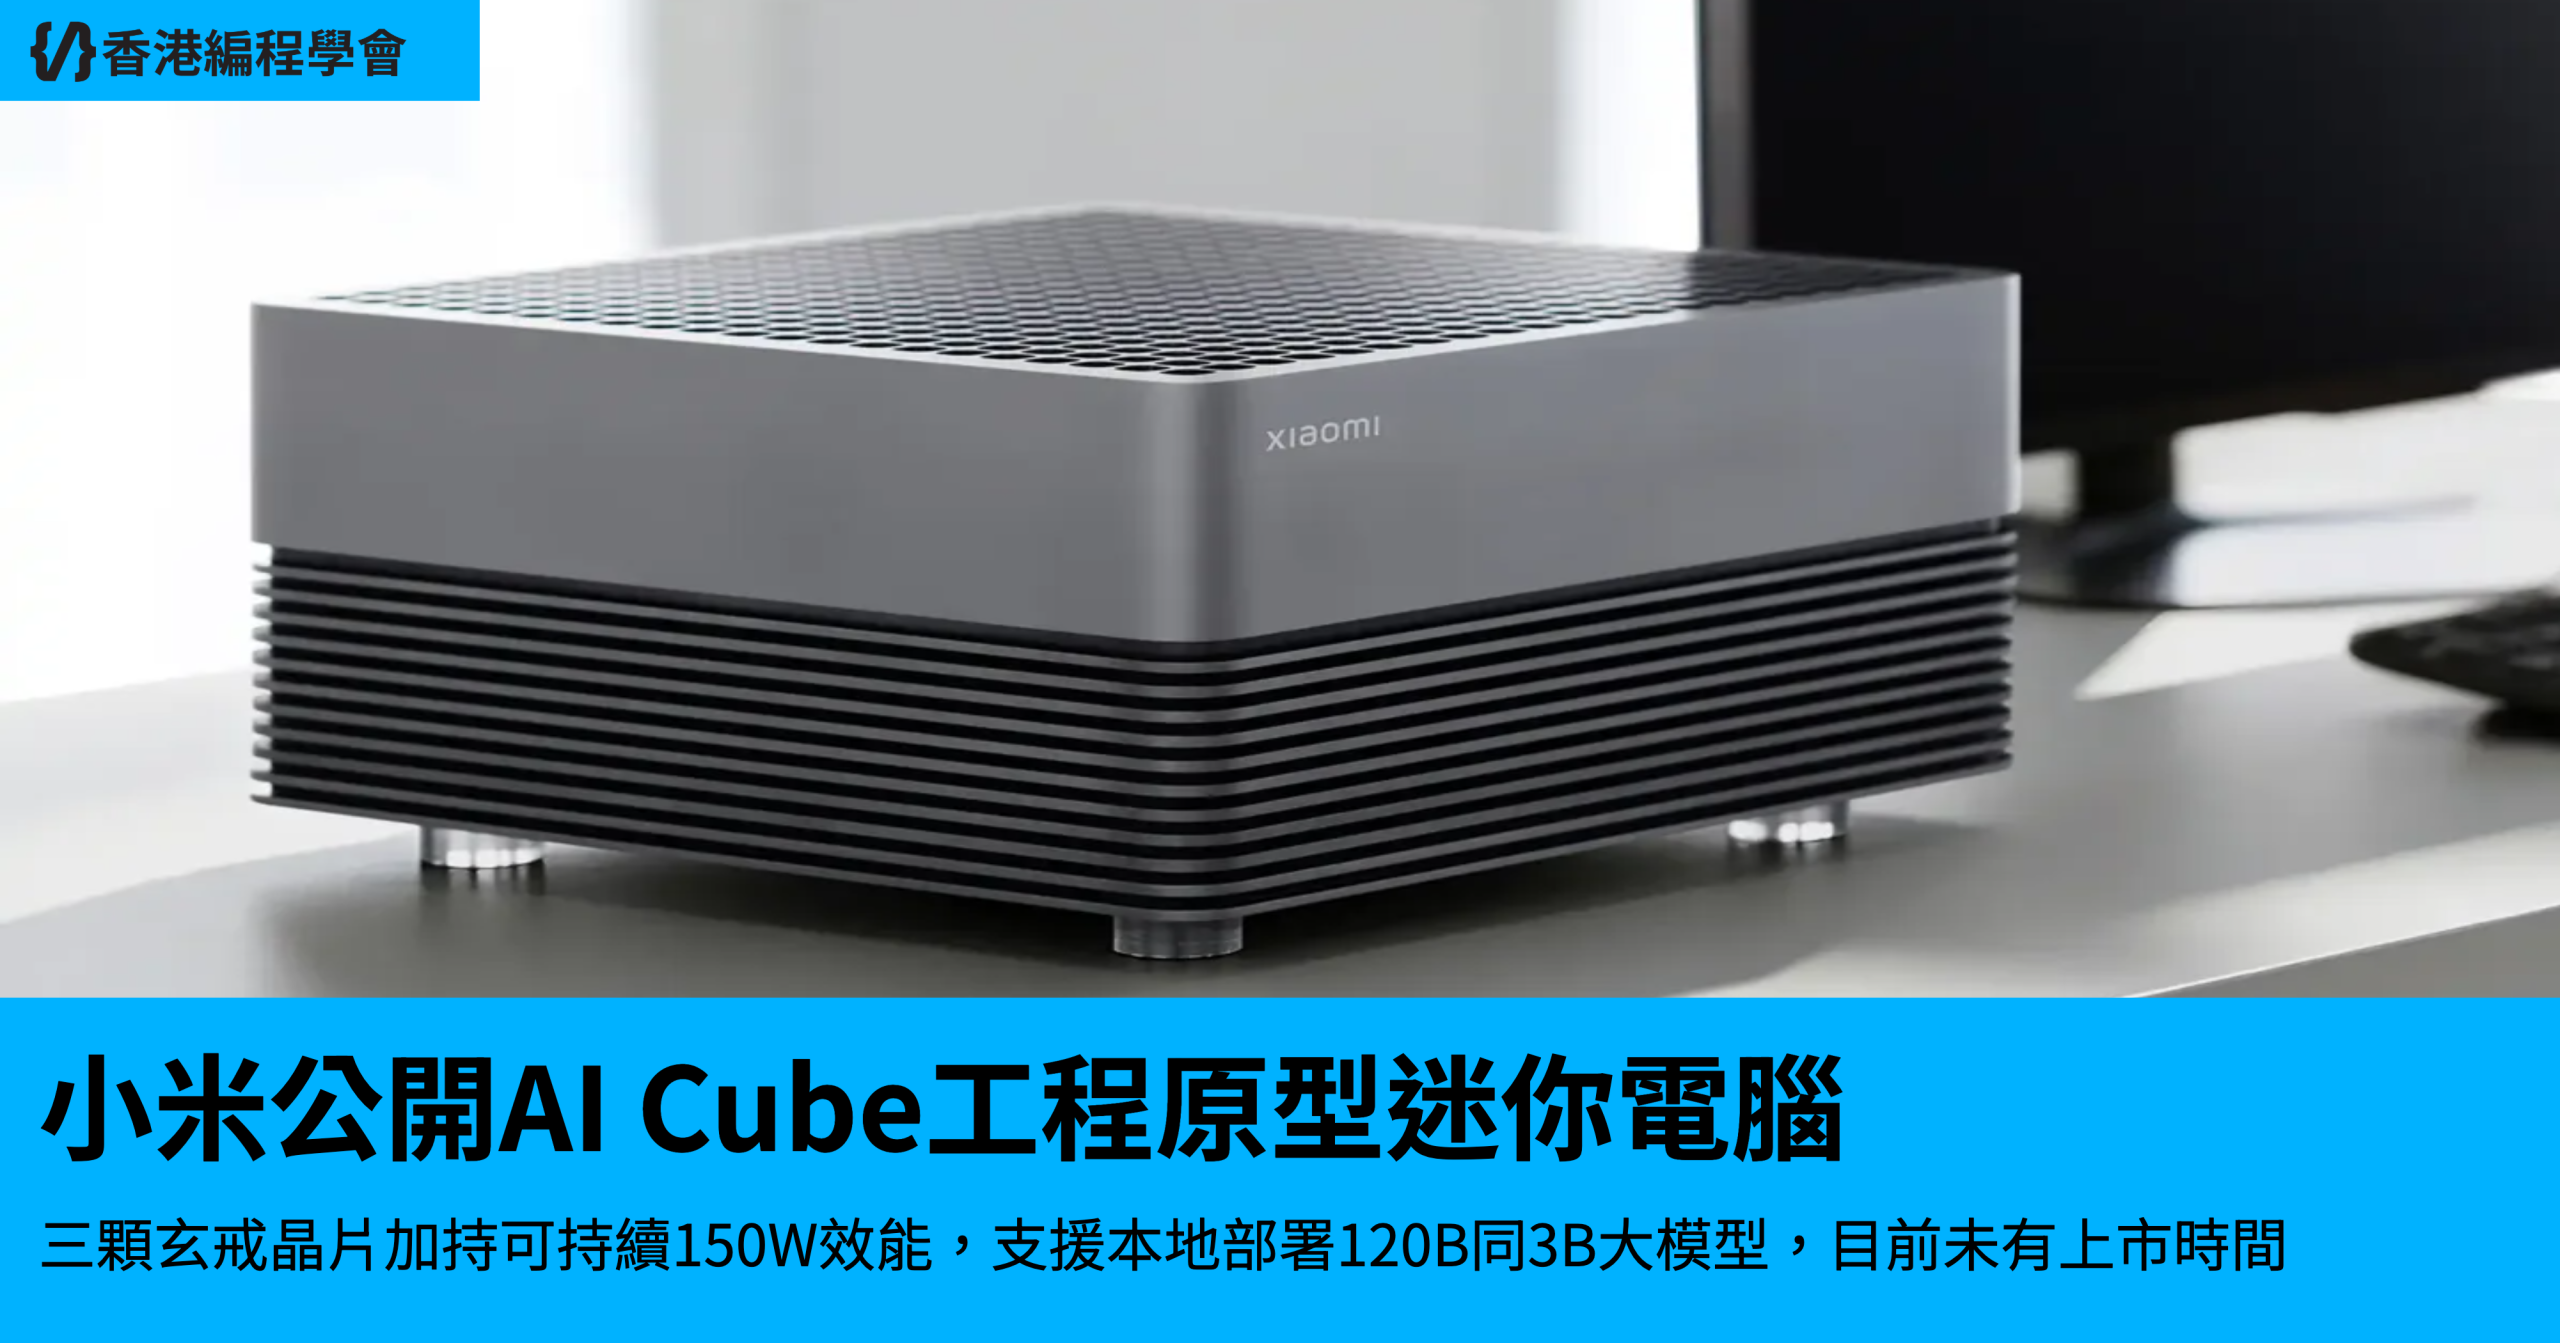
小米喺8月24號嘅玄戒晶片技術溝通會上,亮相咗一款叫AI Cube嘅工程原型迷你電腦。呢部機用咗三顆自家玄戒晶片:O3、O100同D100,專為本地運行AI大模型而設計,可持續釋放高達150W效能。
其中玄戒O3係主處理器,配備10核CPU、16核G2-Ultra NX GPU同200 TOPS NPU;O100係高頻寬AI加速晶片,採用6nm 3D堆疊封裝,近存計算頻寬高達1.22TB/s;而D100就係3nm智駕AI晶片,有20核CPU同16核NPU,最高支援160GB統一記憶體。
機身用航天級鋁合金一體成型,帶有33874個CNC精密鏤孔。官方表示可以本地部署120B同3B大模型,仲支援快慢系統切換。目前O100同D100預計2027年商用,AI Cube本身就未公布售價同上市時間。
https://www.notebookcheck.net/Xiaomi-unveils-AI-Cube-mini-PC-with-three-Xring-chips-and-150-W-performance.1376717.0.html